
前編のおさらい
AIは「品質をバグらせる」増幅器だった
AIは「品質をバグらせる」増幅器だ。Proactive QA(予防型)のチームはAIでプロダクトの品質を「強化させ」、Reactive QC(事後管理型)のチームはAIでプロダクトの品質を「悪化させ」、コストも急増する
前編で紹介した、2つの研究が示したメッセージ。
開発スピードがAIエージェントによって速くなることで、コーディングするコストは下がる。
逆に、以下の3つの負債が積み上がり、プロダクトの品質を「悪化させる」(バグらせる)。
- 理解の負債(Comprehension Debt):「どう動くか」を誰も深く知らない状態
- 意図の負債(Intent Debt):「なぜ作ったか」が消えていく状態
- 複雑性の負債(Complexity Debt):コードベース全体に蓄積する技術的負債
※詳しくは、以下の前編をご参照ください。
また、「ブートストラップ問題」*1という問題も、上記負債から俎上に載る問題として紹介しました。
品質保証は、AI時代の速度に合わせてスケールしなければならない
「テストは後で」「バグが出たら直す」というアプローチは、AI時代においてコストが急増する。
Proactive QA(予防型)のチームがAIでさらに強くなる一方で、Reactive QC(事後管理型)のチームはAIで品質が悪化する——AIは"差"を広げる増幅器でもある。
SDATが提供する「構造」とは
SDATは、MITのWYSIWID(What You See Is What It Dose)論文の構造要素と、品質保証のゴールデントライアングルを組み合わせたテストフレームワーク。
| WYSIWID要素 | QA観点 | 意味 |
|---|---|---|
| Concepts | Where(テスト対象) | 独立した機能単位 |
| Syncs | What(テスト観点) | Concepts間のイベント駆動ルール |
| Actions | How(テスト方法) | Conceptが提供する操作 |
加えて、SDATが独自に体系化した3つの問い(Who / Why & Time / Then Properties)と、AI時代のQA反復単位「Bolt」によって、意図とともに証跡を残す仕組みを作る。
どうも!
AI開発推進部でQA(品質保証)エンジニアを担当しています、たかだ(@tackaaaada)です!
前編では、AIが品質にもたらす「3つの負債」と、それに立ち向かうフレームワーク「SDAT」の構造を紹介しました。
今回の後編では、実際にSDATを使って何が起きたのか。5つのフェーズごとの実践と、その内容についてお話しようと思います。
Before / After:構造が変えたもの
まずSDATを導入して、何が変わったのか。
時間の比較ではなく、構造と成果物で見てみます。
| SDAT導入前 | SDAT導入後 | |
|---|---|---|
| テストスコープ | spec.mdのUI構造をそのまま転記 | ビジネスロジック×システム実装の対応関係+対象外を明示 |
| セッションをまたぐと | ゼロから説明し直し | Concepts/Syncsが引き継ぐ |
| なぜこのテストか | 誰も説明できない | Then Propertiesに残っている |
| 証跡 | テストはあるが意図がない | BoltにWho/Why/Evidenceがセット |
| バグが出たとき | 「何かおかしい」 | どのConceptの欠陥か特定できる |
上記から、
- 構造を決めるのは、人間
- 大枠を作るのが、AI
- 足りない部分を補完するのが、人間
この役割分担が、Before/Afterの差を生んでいます。
ツールスタック
次に、ツールスタックをご紹介します。
SDATの実践を支えたツールは、3つです。
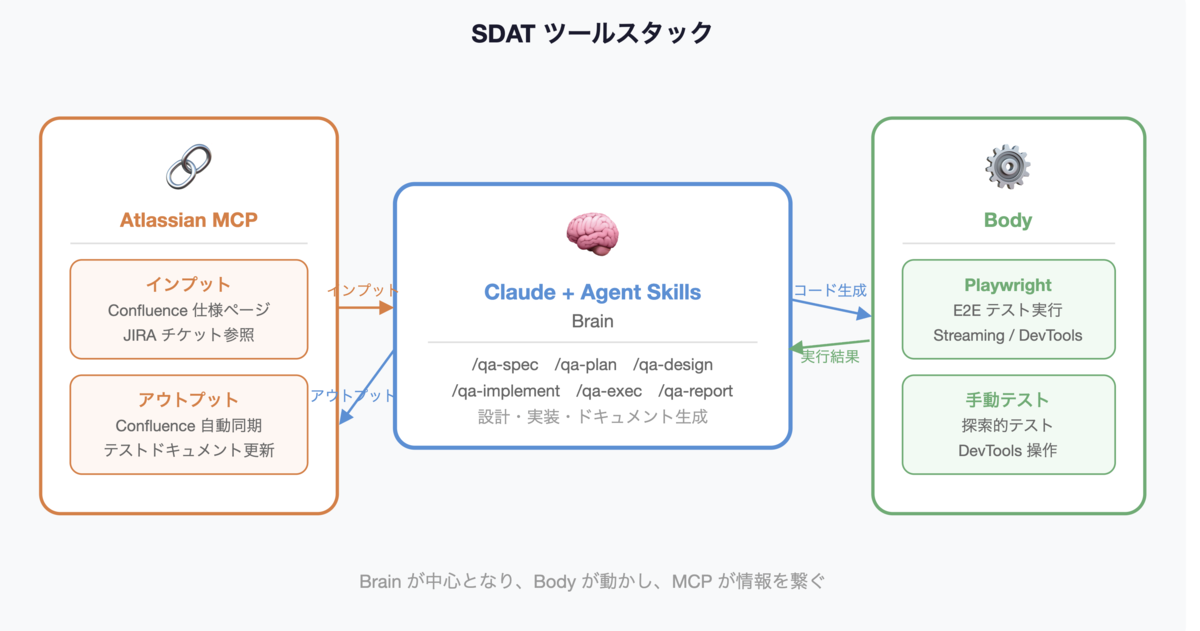
🧠 Claude + Agent Skills*2(Brain)
テスト計画・設計(分析含む)・実装・実行・完了といった、テストプロセスごとのドキュメント生成を担います。spec.mdの作成からViewpoint Matrixの生成、Playwrightコードの生成まで、設計と実装の中核を担うパートナーです。
⚙️ Playwright(Body)
テスト実行*3エンジンです。Agentが生成したテストコードを実行し、結果をMarkdown形式で出力します。AIプロダクトにて生成文章の機能テストやDevToolsレベルの検証も、ここで動きます。
🔗 Atlassian MCP(Nervous System)
ConfluenceとJIRAの連携を担います。弊社では仕様書をConfluenceで管理しているため、仕様書の読み込みや、Agent SkillsがMCP経由でConfluence APIを直接操作し、テストドキュメントを同期します。これにより「後から整理する」が発生しません。
各フェーズの紹介
各フェーズでは、Brainに当たるClaude + Agent Skillsがドキュメント生成を担います。
それぞれに対応したスキルが用意されており、コマンドひとつでSDAT準拠のドキュメントを生成します。
スキル一覧
| コマンド | フェーズ | 生成される成果物 |
|---|---|---|
/qa-spec |
PLAN | spec.md(テスト仕様書) |
/qa-plan |
PLAN | plan.md(テスト計画書) |
/qa-design |
DESIGN | test-design.md(テスト設計) |
/qa-implement |
IMPLEMENT | テストケース作成 |
/qa-exec |
EXEC | テスト実行レポート(※) |
/qa-report |
REPORT | テスト完了報告書・GO/NO-GO判定 (※) |
※:今回の記事での詳細な解説は、割愛させていただきます。ただ、スキルのコマンドを実行する際は、後述する各プロセスのインプットと同様、前工程の成果物をインプットにして実行するようにしています。
ではここから、各テストプロセスごとの実践内容と実践してわかったことを、以下に掲載します。
qa-spec:テスト仕様の構造化
新規・既存に関わらず、どの機能が存在していて、どのように動くのか。
PRD(Product Requirements Document)のように「プロダクトとして、何を成功とみなすか*4」や、プロダクトの仕様書から、知ることが必要です。
qa-specでは、テスト仕様書(spec.md)を作成するスキルとして、Concepts / Synchronizationsの構造で仕様を記述します。
どんな機能(Concepts)があって、どのように動く(Synchronizations)といったことを、まとめていきます。
以下に、qa-specのSKILL.mdを抜粋して掲載していきます。
スキルの入力(SKILL.mdの抜粋)
Concept: [名前]

- Purpose: 何を管理するか
- Who (Access Policy): Public / Admin / User(Owner) / Guest
- State: Conceptが持つ状態変数
- Actions: Conceptが提供する操作

sync [名前]

- when: どのActionが完了したとき(出力`=>`が返ってきた瞬間)
  ※呼び出し時ではなく完了時に発火
- where: どの状態条件下で(Concept A が State X にあるとき)
- then: どうなるべきか(Concept B が State Z に遷移する)
- Temporal Logic: Eventually / During / Immediately
出力例(spec.mdの一部)
## 1. Concepts (Where) - The Actors & Objects

### FeatureAPI

- **Purpose**: AI処理機能(変換タイプA / 変換タイプB / 変換タイプC)を管理する
  - 通信方式: Streaming(Chunkごとのレスポンス)
- **Who (Access Policy)**: 一般ユーザー / 管理者
- **State**:
  - processType (変換タイプA / 変換タイプB / 変換タイプC)
  - streamingStatus (未開始 / 受信中 / 完了 / エラー)
  - outputText (string)  # 生成されたテキスト
- **Actions**:
  - processTypeA(inputText, option) → StreamingResponse | error
  - processTypeB(inputText) → StreamingResponse | error
  - processTypeC(inputText) → StreamingResponse | error

## 2. Synchronizations (What) - The Scenarios

### User Story N - AI機能:変換タイプB

1. **Scenario**: 変換タイプBでの出力表示
   - **Given** [FeatureAPI] streamingStatus = 未開始, 入力テキストが存在する(編集モード)
   - **When** 変換タイプBのボタンを押して processTypeB() を実行する
   - **Then** outputText が期待するフォーマットで表示される
     - _Property_: 出力テキストが空でなく、変換タイプBの形式で表示される

2. **Scenario**: API分離の確認(探索的テスト)
   - **Given** DevTools で typeA のエンドポイントを Block Requests に設定
   - **When** 変換タイプBのボタンを押す
   - **Then** typeB のエンドポイントは影響を受けず、正常に表示される
     - _Property_: 各エンドポイントが独立しており、互いに影響しない
インプットに使用しているのは、プロダクトの仕様書やPRD。既存機能の保守については、それにプラスして実装のソースコードをインプットにしています。
Claude(Claude Code, またはCowork)に、/qa-spec @<仕様書のファイル名> を元に、テスト仕様書を作成してください。といった形で指示します。
Conceptについては、仕様書やPRDに掲載している機能名をテストドキュメント用に簡略化したものを出力しています。
またSynchronizationsは、「ユーザーストーリーをGherkin記法で出力」しています。
時には、仕様書の書きっぷりが変わる(フォーマット違いや、内容の粒度の違い、書き手の性格の違いなど)ことも考えられます。
そういった状態で与えられた情報を整理するときに、テスト対象(Concepts) と テスト観点(Synchronizations) をSKILL.mdに構造を定義して出力しています。
ここで整理するのは、ビジネスロジック と そのビジネスロジックを実現する機能やシステム を洗い出すということを実行しています。
qa-plan:テスト計画書でのアウトライン定義
テスト対象とテスト観点(まだ粗い状態ですが)を洗い出したら、その規模感・粒度・Severityといった重要度(もしくは、Priorityといった優先度)をもとに、「テストの骨格」を見出す必要があります。
レシピも無しに、「ブッシュ・ド・ノエルを作れ*5」と言われたら、困りますよね?
qa-planでは、テスト計画書(plan.md)「SDATにおけるWho / When / Why / Whatの4鉄則に基づいて、テストの骨格」を作ります。
スキルの入力(SKILL.mdの抜粋)
## テスト計画の4鉄則(必須)

| 鉄則  | 問い                                 | WYSIWID対応                   |
| ----- | ------------------------------------ | ----------------------------- |
| Who?  | 誰がテストするか・誰のためのテストか | Concepts(Actors)の定義      |
| When? | リリース日・テスト期間               | Temporal Logic(時間軸)      |
| Why?  | テスト目的・背景                     | Syncs の存在理由(Causality) |
| What? | 主要なシナリオ                       | Key Synchronizations          |
出力例(plan.mdの一部)
## Scope & Risk (Who/When/Why/What)

**Why (Purpose)**:
Rails アップグレード後に、ユーザーが日常的に使用するすべての主要機能が
破壊されていないことを自動検証する。特に破壊的変更が一覧表示・日時処理・
バックグラウンドジョブに与える影響を早期検出し、リリース判定の根拠とする。

**Who (Actors/Concepts)**:

- **先生(保育士)**: レポート作成・閲覧・AI要約機能を日常的に使用するメインユーザー
- **先生(管理者権限)**: 先生の権限 + 一部管理機能
- Access Policy: User(Owner)/ Admin

**When (リリース目標)**:
| フェーズ | 目安日程 |
|---|---|
| QA設計・実施準備 | 〜 YYYY-MM-DD |
| QA実施 | YYYY-MM-DD 〜 1〜2週間 |
| リリース | YYYY-MM-DD |

**What (Key Synchronizations)**:

_Bolt 1: ログイン・一覧・詳細_

1. ログイン後のダッシュボード表示の確認(US1)
2. 一覧画面の表示順の確認(アップグレードの影響)(US2)
3. レポート作成・保存の確認(US3)

_Bolt 2: AI要約機能_

4. 要約機能による要約文表示の確認(文字数要約)(US4)
5. 要約機能による要約文表示の確認(箇条書き変換 + API分離確認)(US5)
さきほど作成した、spec.mdをインプットに、/qa-plan @<spec.mdのファイル名>を元に、テスト計画書を作成してください。といった形で指示し、テスト計画書を作成していきます。
テストスコープの洗い出し、スケジュール(想定)、目的や想定ユーザーの属性といったことも、ドキュメントとしてまとめていきます。
spec.mdにてテスト対象とテスト観点が洗い出されている状態なので、それらを元に上記の内容を作成していきます。
これで、テストのアウトライン = 骨格 を形成し、肉付けである「テスト分析・設計」のプロセスに移っていきます。
qa-design:テスト分析・設計によるViewpoint Matrixの定義
肉付けするにも、骨格に合わせて全体のバランスを見つつ、また接近してディテールを詰めて神経などを接合して付ける必要があります。
qa-designでは、テスト設計書(test-design.md)、「作成したテスト計画書と関連する開発ドキュメントを元に、SyncsとConceptsをマトリクスにとりまとめ、Viewpoint Matrix(テスト観点表)」を作成していきます。
スキルの入力(SKILL.mdの抜粋)
## Viewpoint Matrix の列定義

| 列名          | 説明           | 記述ルール                             |
| ------------- | -------------- | -------------------------------------- |
| ID            | テスト観点ID   | [PJコード]-[機能コード]\_[種別]-[連番] |
| 観点          | 何を確認するか | 「〜の確認」形式で記述(必須)         |
| 対象          | テスト対象     | Concept IDで参照                       |
| 方法          | テスト方法     | Small/Medium/Large + 手動/自動         |
| 条件 (Given)  | 前提条件       | 状態・データ・環境を明記               |
| Then Property | 満たすべき性質 | 「〜であること」形式(不変条件)       |
| 想定ケース数  | 派生ケース数   | 数値で記述                             |
出力例(test-design.mdの一部)
## 2. Concepts Definition(テスト対象)

| Concept ID | 名前               | 種別 | 役割                                 |
| ---------- | ------------------ | ---- | ------------------------------------ |
| CPT-001    | `LoginPage`        | UI   | ログインフォームの操作・ページ遷移   |
| CPT-002    | `DashboardPage`    | UI   | ログイン後のダッシュボード表示確認   |
| CPT-003    | `ChildListPage`    | UI   | 一覧の表示・並び順確認               |
| CPT-004    | `ReportEditorPage` | UI   | レポート編集モード・保存操作         |
| CPT-005    | `FeatureAPI`       | API  | AI処理 Streaming API(3エンドポイント) |

## 3. Viewpoint Matrix

| ID            | 観点 (Viewpoint)                                       | 対象             | 方法        | 条件 (Given)              | ISO25010 Tag                        | Then Property                                                              | 想定ケース数 |
| ------------- | ------------------------------------------------------ | ---------------- | ----------- | ------------------------- | ----------------------------------- | -------------------------------------------------------------------------- | ------------ |
| PJ-REG_FC-001 | 有効な資格情報でのログイン成功の確認                   | CPT-001, CPT-002 | Large (E2E) | 未ログイン状態            | Functional suitability/Correctness  | ダッシュボードへ遷移し、URLが期待パターンに一致すること                    | 1            |
| PJ-REG_EC-001 | 無効な資格情報でのログイン失敗の確認                   | CPT-001          | Large (E2E) | 未ログイン / 誤パスワード | Security/Confidentiality            | ログインページを離れずエラーが表示され、セッションCookieが発行されないこと | 1            |
| PJ-REG_FC-002 | 一覧の表示順の一貫性の確認                             | CPT-003          | Large (E2E) | ログイン済み / 一覧画面   | Functional suitability/Correctness  | 並び順が連続2回の取得で完全一致すること                                    | 2            |
| PJ-REG_FC-003 | AI機能(変換タイプB)での出力表示の確認                | CPT-004, CPT-005 | Large (E2E) | ログイン済み / 編集モード | Functional suitability/Completeness | 変換タイプBの形式で出力テキストが表示されること                            | 1            |
| PJ-REG_EC-002 | AI機能のサーバーエラー時のエラーメッセージ表示の確認   | CPT-004, CPT-005 | Large (E2E) | ログイン済み / APIをabort | Reliability/Fault tolerance         | エラーメッセージが10秒以内に表示され、エディタがハングしないこと           | 1            |
ここでは、観点・対象・方法の他に、「Then Property」といった形で期待値を入れていきます。
あとは、対応する品質特性をタグ付けして品質のコンテキストとの紐付けをします。
ここまで、流れの間で解説していきましたが、人間側のほうで注意しなきゃいけないのは「漏れがないか」を批判的思考しながら問い続けて更新していく必要があります。
盲目的に信じてそのまま採用するのではなく、人間側のレビューも入れつつ手を加える(追記したり、修正したり)ことも必要です。
さて、観点表も出来てきたのでここいらで「テストケース作成(テスト実装)」に入っていきます。
qa-implement:Conceptsをコードに、Syncsをテストに
テスト設計書もできて、ここから実装に入っていきます。
Concepts → Fixtures → Syncsの3ステップで、テスト設計書をインプットに、Playwrightのテストコードや手動テストケースに落とし込みます。
スキルの入力(SKILL.mdの抜粋)
## WYSIWID 実装フロー(3ステップ)

1. Concepts  → Page Objects / API Clients として実装(互いに独立)
2. Fixtures  → テストデータのセットアップ(Given の実現)
3. Syncs     → テストシナリオ(Concepts + Fixtures を組み合わせ)
出力例①:自動テスト(Playwrightコードの一部)
// Step 1: Concepts(Page Object)
interface FeatureAPI {
  processTypeA(inputText: string, option: number): Promise<StreamingResponse>;
  processTypeB(inputText: string): Promise<StreamingResponse>;
  // 各エンドポイントが独立したActionとして定義される
}

// Step 2: Fixtures(テストデータ)
// TD-001: 一般ユーザーロール / status=Active(storageState で再利用)
// TD-002: 入力テキスト(長文 / 日本語テキスト)

// Step 3: Syncs(テストシナリオ)
// Viewpoint Matrix の観点1行 = テストケース1件に対応
test('PJ-REG_FC-008: AI機能(変換タイプB)での出力表示の確認', async ({ page }) => {
  // Given(Where: Conceptの状態設定)
  // ログイン済み / 編集モード / 入力テキストが存在する

  // When(Actions on Concepts)
  await EditorPage.clickProcessTypeBButton();

  // Then(Property の検証)
  const outputText = await FeatureAPI.getOutputText();
  expect(outputText).toMatch(/期待するフォーマットのパターン/);  // 形式が正しいこと
  expect(outputText.length).toBeGreaterThan(0);  // 空でないこと
});
出力例②:手動テスト(テストケース手順書の一部)
### シナリオ: PJ-REG_UI-001 ネットワーク遮断後の再試行で処理が完了することの確認
- **種別**: 手動テスト(DevTools操作を含むため自動化対象外)
- **証跡ポリシー**: Recorderツール(操作ログ / スクリーンショット)で証跡を残す

- **前提条件(Given)**:
  - ログイン済み / 編集モード / 入力テキストが存在する

- **手順(When)**:
  1. DevTools を開き、対象エンドポイントを Block Requests に設定する
  2. 処理実行ボタンを押す
  3. エラーメッセージが表示されることを確認する
  4. Block Requests を解除する
  5. 再度、処理実行ボタンを押す

- **期待結果(Then)**:
  - 再試行後に出力テキストが正常に表示されること
  - *Property*: エラーメッセージを経由して再試行した場合のみ処理が完了し、
    Block解除だけでは処理が再開されないこと
手動テストに関しては、PJの特性によっては表形式にして書くことが必要になることもあるかもしれません。
その際は、テンプレートを用意した上でテストケースを作成していきます。
qa-constitution:SDATの「憲法」
もう一つ、全体的なルールや考えを定義したものも用意しています。
それが、qa-constitutionというSDATの基本原則と哲学を定義したスキルです。
ルールだけでなく「なぜそのルールが存在するか」まで明文化しています。
スキルの入力(SKILL.mdの抜粋:哲学)
### VII. Philosophy of SDAT

1. Simple over Easy(単純さは安易さに勝る)
   Easy(安易): 深く考えずにAIに丸投げすること。
   Simple(単純): 構造上の複雑さを排除し、意図(Why)と構造を明快にすること。
   我々は「Easy」ではなく「Simple」を追求する。

2. Structure over Brute Force(構造は力業に勝る)
   「Structure (Concepts/Syncs)」に基づくアプローチは、
   失敗すらも「どの構造の欠陥か」という知識として蓄積される。

3. Active Engineering(能動的エンジニアリング)
   AIに「方法(How)」を教えるのではなく、
   「エンジニアリング(Why & Structure)」を教える。
   「Who?」「Why?」を能動的に問い続けることで、バイアスを最小化する。
この憲法が「全スキルの根拠」として機能することで、セッションをまたいでも・担当者が変わっても、SDATの原則が一貫して引き継がれるようにしています。
実践してわかったこと
PLAN:一番泥臭かった
計画フェーズは、5フェーズの中で最も泥臭かったフェーズです。
テストスコープの抽象度をどう決めるか、が核心でした。
最初はspec.mdの構造をそのままConceptsに変換しようとしていました。しかし、spec.mdはUI設計の視点で書かれているため、そのままConceptsにすると粒度が細かすぎて「テスト可能な振る舞いの単位」になりませんでした。
試行錯誤の末にたどり着いた考え方は、
テストスコープとは「ビジネスロジックをシステムがどう実現するか」の概要である
つまり、UIコンポーネントを列挙するのではなく、ビジネスの意図とシステムの実装を対応させることがスコープ定義の本質だということです。
実際のテストスコープの例を見ると、
| エンドポイント | ボタン(ビジネス意図) | リクエストbody |
|---|---|---|
| POST .../process_type_a_stream | 変換タイプA実行 | {"text":"...", "option": 1000} |
| POST .../process_type_b_stream | 変換タイプB実行 | {"text":"..."} |
| POST .../process_type_c_stream | 変換タイプC実行 | {"text":"..."} |
というように、対照するようにそれぞれを紐付けています。
そして、「テスト対象外」を明示することも同じくらい重要でした。
「何をする」だけでなく「何をしないか」を決めて、初めてスコープは固まります。
- テスト対象外:モデル精度・出力品質
- テスト対象外:言語品質
- テスト対象外:保存後のデータ永続化(別スイートが担当)
- テスト対象外:スマホ・タブレット端末
また、spec.mdの「Synchronizations(What)——The Scenarios」を考えつくものを洗い出す作業も、地道でした。
ここは人間側で批判的思考を働かせながら、「逆の順・逆の方法」「似ている別のパターン」を意識的に探し出す必要があります。
DESIGN:AIが大枠を作り、人間が補完する
設計フェーズでは、Viewpoint Matrix(SyncsとConceptsのマトリクス)を作成します。
ここでの人間とAIの役割分担は、
- AIが得意:Viewpoint Matrixの大枠を作ること、重複観点を出さないこと
- 人間が得意:「逆の観点・類似パターン」を批判的思考で補完すること
というように、はっきりしていました。
重要なのは、誤りの方向が「過多より過少」だということです。
AIは観点を増やしすぎることはほぼなく、足りないことがある。だから人間のレビューの焦点は「これは余分じゃないか」ではなく「これは抜けていないか」に絞れます。
Concepts Definition(Whereの定義)の漏れも、人間側が意識しながらレビューする必要があります。
まず全体像を把握してから、細かい観点の補完に入るという順番が、効率的でした。
IMPLEMENT:構造があるから「何を」は迷わない
実装フェーズでは、ConceptsをPage ObjectやAPI Clientとして実装し、SyncsをPlaywrightのテストコードとして書いていきます。
構造(Concepts/Syncs)があるから、「何を実装するか」は迷いません。
ただ、難しかったのは「どう実装するか」でした。
特にStreaming系のテストは地道でした。
- ステータス確認
- Chunkごとのレスポンス受信確認
- 低速ネットワークでの検証
- DevToolsを使った挙動確認
これらを、1個1個挙動を確かめながらPlaywrightのテストコードに書き起こしていきます。
エージェントがコードを生成・実行して結果を提示し、人間がレビューするサイクルを繰り返しました。
StreamingやDevToolsレベルの検証は、プロトコルレベルの知識が必要な部分です。ここは人間の判断が欠かせません。
まとめ
- PLANへの投資が全フェーズの質を決める。テストスコープは「ビジネスロジック×システム実装の対応関係」で定義し、「対象外」も明示する
- 人間とAIの役割分担は明確——「構造を決めるのが人間、大枠を作るのがAI、批判的思考で補完するのが人間」
- 構造があるから、セッションをまたいだ引き継ぎも、スムーズになる
QAエンジニアの役割変革:「品質のモデラー」へ
QAエンジニアは、「品質とは何か」を構造的に理解・構築・定義し、チームとAIの両方が理解できる形で形式知化する——それが本来の役割だと考えています。
それは、テスト手順通りに動作を確認することや、開発者の成果物に何かしらを指摘することからは、生まれないものです。
非決定的なAIの出力によって、品質の複雑性が増している今の「生成AIの時代」。その真っ只中において「AIが文脈(Why)を理解できる構造を作ること」が、SDATが目指したことです。
Who・Why & Time・Then Propertiesを明文化するプロセスは、単なるテスト効率化ではなく、AIをテストパートナーとして機能させるための学習フェーズでもある。
長年の経験知(Golden Triangle)をWYSIWIDという構造に流し込み、AIとともに品質の「Why」を問い続ける——
それが、ユニファ株式会社のQAエンジニアである高田が考えた「QAエンジニアの次のロール——品質のモデラー(Quality Modeler)」として、品質の価値をチームに語れる「ストーリーテラー」になることだと考えています。
おわりに
前編と後編にわたって、色々と書かせていただきました。
ここまでお読みいただいて、ありがとうございました。
ご参考になれれば、幸甚です。
では、また。
ユニファでは一緒に働いてくれる仲間を募集しています。 興味を持っていただけたら、採用情報もあわせてご覧ください。 jobs.unifa-e.com
*1:同じ盲点を共有したテストが生まれ、人間のドメイン知識が介在しない「同じ誤解を共有しているためにPassしてしまうテストが生まれてしまう」問題
*2:SDATの5フェーズを支えるのが、Claude(Claude Code / Cowork)上で動作する「Agent Skills」です。ここでは、各フェーズに対応したスキルが用意されており、コマンドひとつでSDAT準拠のドキュメントを生成します。
*3:自動テストを実行するときに使用します
*4:背景、解決したい課題、対象ユーザー、目標、やらないこと、市場や競合のコンテキストをとりまとめたドキュメントと認識しています。
*5:「クリスマスの木」という名前の、丸太や切り株の形をイメージした、代表的なクリスマスケーキの一つ。
